大家好,我是超哥。今天给大家分享 Qwen3.6 35B 无限制版本地部署教程。这是一款自由度非常高的开源越狱版大语言模型,支持本地免费使用,部署过程也非常简单,几分钟就能完成。下面我们开始教程。
一、下载并安装 llama.cpp
下载地址:https://github.com/ggml-org/llama.cpp/releases
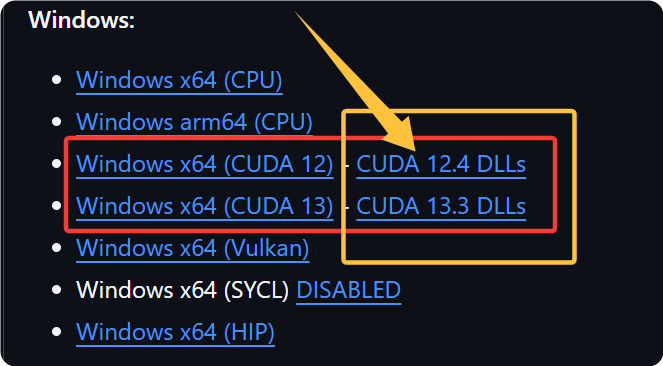
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
二、下载 Qwen3.6-35B-A3B 本地大模型
下载地址:https://huggingface.co/LuffyTheFox/Qwen3.6-35B-A3B-Uncensored-Genesis-Hermes-V3-GGUF/tree/main
要求:显卡显存要求8GB以上
下载到的大模型和多模态文件放到llama.ccp程序的根目录下的models目录里(需自行创建目录)
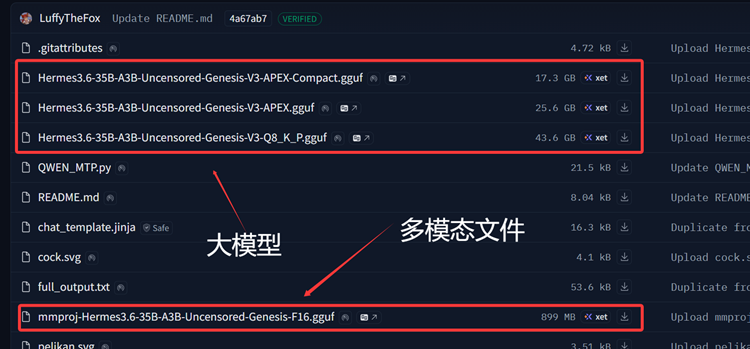
| 模型版本 | 文件大小 | 最低显存 |
|---|---|---|
| APEX Compact | 17.3GB | 8GB |
| APEX | 25.6GB | 10GB~12GB |
| Q8_K_P | 43.6GB | 12GB(理论可运行) |
三、配置启动 Qwen3.6-35B-A3B
在 llama.cpp 程序根目录创建启动脚本,命名成:启动.bat
@echo off
cd /d "%~dp0"

llama-server.exe ^
-m "models\Hermes3.6-35B-A3B-Uncensored-Genesis-V3-APEX-Compact.gguf" ^
--mmproj "models\mmproj-Hermes3.6-35B-A3B-Uncensored-Genesis-F16.gguf" ^
-ngl 999 ^
-c 8192 ^
--flash-attn auto ^
--jinja ^
--host 0.0.0.0 ^
--port 8089

pause
访问控制面板 URL:
其它版本:创建启动脚本,命名成:启动.bat
@echo off
cd /d "%~dp0"

llama-server.exe ^
-m "models\模型主文件名称(如:Hermes3.6-35B-A3B-Uncensored-Genesis-V3-APEX.gguf)" ^
--mmproj "models\mmproj-Hermes3.6-35B-A3B-Uncensored-Genesis-F16.gguf" ^
-ngl 999 ^
-c 8192 ^
--flash-attn auto ^
--jinja ^
--host 0.0.0.0 ^
--port 8089

pause