大家好,我是超哥。今天给大家分享 Inkling 2 Mini 无审查版 AI 大模型的本地部署教程!这款模型拥有约 264 亿总参数,基础激活参数约 34 亿,模型支持最长 100 万 超长上下文,同时支持文字和图片输入,最小 8GB 显存的显卡就能运行,而且在代码编写、复杂推理以及 Agent 工具调用等任务上都有不错的表现。今天我们将使用 LocMod 在本地部署这款模型,下面我们开始教程!
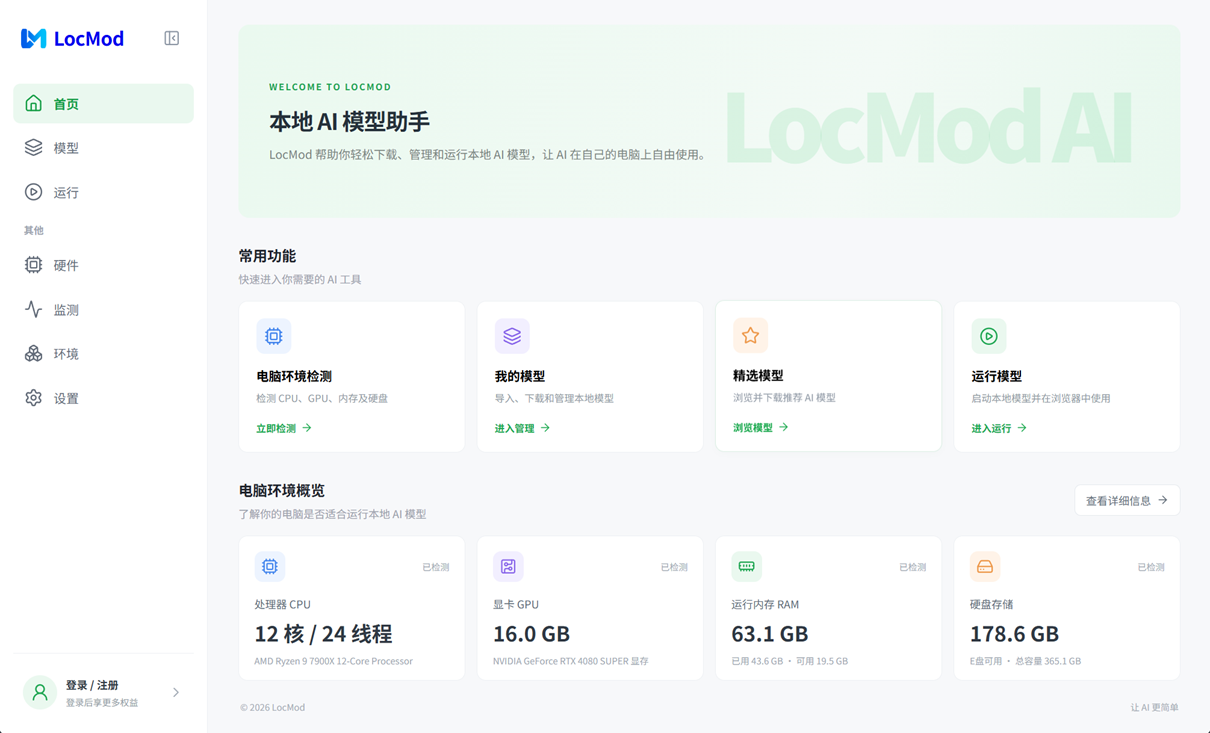
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB DDR5(3600 MHz)
一、LocMod 软件下载安装
LocMod 官方下载地址:https://locmod.com
LocMod 网盘下载地址:https://pan.quark.cn/s/8fb5340e2806?pwd=YPYc
二、环境部署
1. 在线自动部署(能快速访问Github)
直接点击软件里的"立即安装"按钮自动部署。
2. 手动下载部署
下载下面链接里的环境文件,软件里导入下载到的压缩包即可。
llama.cpp 夸克网盘下载地址:https://pan.quark.cn/s/814d913a0335?pwd=UZj4
Github 下载地址:https://github.com/ggml-org/llama.cpp/releases
三、Inkling 2 Mini 模型部署
模型 Hugging Face 地址:https://huggingface.co/AtomicChat/Inkling-2-Mini-Uncensored-GGUF/tree/main
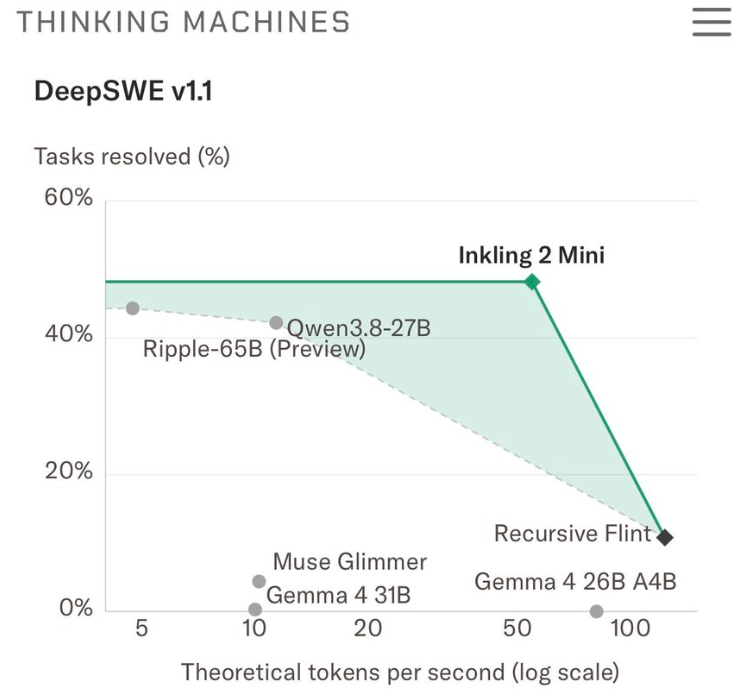
Inkling 2 Mini 与 Qwen 3.8 27B 对照图:
电脑配置模型选择推荐:
| 模型版本 | 文件大小 | 适用显存 | 推荐说明 |
|---|---|---|---|
| AD-IQ2_M | 约 8.67 GB | 8GB 显存及以上 | 低比特量化版本,文件较小,适合显存有限的用户 |
| AD-IQ3_S | 约 13.3 GB | 12GB 显存及以上 | 3-bit 量化版本,在模型体积与精度之间取得平衡 |
| AD-Q4_K | 约 16.5 GB | 16GB 显存及以上 | 4-bit 量化版本,适合追求更高模型精度的用户 |
| mmproj-BF16 | 约 642 MB | -- | BF16 多模态视觉投影模块,用于支持图片输入 |
| mmproj-F16 | 约 639 MB | -- | F16 多模态视觉投影模块,用于支持图片输入 |
1、在线自动部署(能够访问 Hugging Face)
软件里“精选模型”里搜:Inkling 2 Mini 无审查版
点击"海外(HF)下载"按钮进行自动下载部署。
2. 手动下载部署
点击"网盘下载"获取模型文件,然后点击"导入模型"进行部署
夸克网盘模型下载地址:https://pan.quark.cn/s/9d82d9d7f9d3?pwd=56aL
四、接入 DeepSeek Harness
DeepSeek Harness 下载地址:https://www.deepseek.com/harness/
接入参数:
Provider ID: sensenova-loop-9B
显示名称: sensenova-loop-9B
API 地址:http://127.0.0.1:端口号/v1
API 协议: OpenAI Chat Completions
API Key: 随便填一个
添加模型:点击"获取可用模型"