大家好,我是超哥。今天给大家分享 Air-26B-A4B 多模态 AI 大模型的本地部署教程!这款模型基于 Google Gemma 4 26B-A4B,拥有约 252 亿总参数,每次推理激活约 40 亿参数。经过 Air 量化优化,模型体积从 50.5 GB 缩小至 13.5 GB,同时推理速度提升 2 倍。它支持图片识别、最高 131K 上下文。今天我们将使用 llama.cpp 在本地部署,下面我们开始教程!
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB DDR5(3600 MHz)
一、大模型下载
夸克网盘模型下载地址:https://pan.quark.cn/s/3ed94b7186a5?pwd=7e4g
Hugging Face 主模型下载地址:https://huggingface.co/webAI-Official/Air-26B-A4B-gguf/tree/main
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
夸克网盘下载地址:https://pan.quark.cn/s/344f9b6a6430?pwd=F5Sz
Github 下载地址:https://github.com/ggml-org/llama.cpp/releases
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
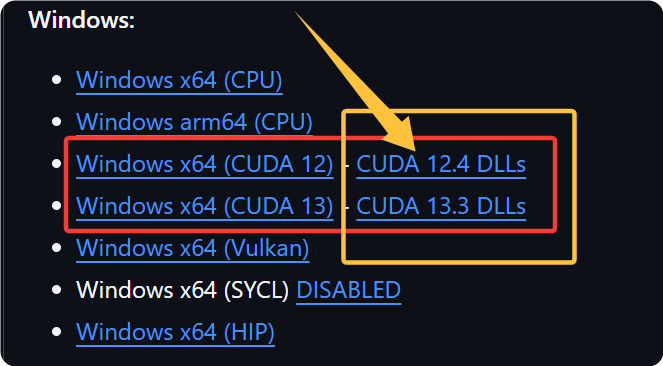
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、AI 模型 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
@echo off
chcp 65001 >nul
title Air-26B-A4B Multimodal - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       Air-26B-A4B
echo       Multimodal llama.cpp Server
echo ========================================
echo.

llama-server.exe ^
  -m "models\Air-26B-A4B.gguf" ^
  --mmproj "models\mmproj-Air-26B-A4B-f16.gguf" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 16384 ^
  -np 1 ^
  --fit on ^
  -fa on ^
  --jinja ^
  -ctk q8_0 ^
  -ctv q8_0 ^
  -ngl 99 ^
  --alias Air-26B-A4B ^
  --temp 1.0 ^
  --top-p 0.95 ^
  --top-k 64 ^
  -n 16384

pause
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 模型名 | 指定 Air-26B-A4B 主模型文件 |
| --mmproj | 多模态名 | 指定多模态投影文件,用于图像输入处理 |
| --host | 127.0.0.1 | 仅允许本机访问模型服务 |
| --port | 8085 | 设置服务监听端口 |
| -c | 16384 | 上下文长度,最大131072,数值越大速度越慢 |
| -np | 1 | 设置单路并行处理 |
| --fit | on | 自动调整模型配置,以适配可用硬件资源 |
| -fa | on | 开启 Flash Attention,优化注意力计算性能 |
| --jinja | 开启 | 启用 Jinja 聊天模板处理,适配模型原生对话格式 |
| -ctk | q8_0 | 设置 K(Key)缓存为 8-bit 量化 |
| -ctv | q8_0 | 设置 V(Value)缓存为 8-bit 量化 |
| -ngl | 99 | 尽可能将模型层加载到 GPU |
| --alias | Air-26B-A4B | 设置 API 中使用的模型名称 |
| --temp | 1.0 | 控制生成随机性,数值越高,输出通常越有创造性 |
| --top-p | 0.95 | 设置核采样阈值,控制候选 Token 的选择范围 |
| --top-k | 64 | 限制每次采样时参与选择的候选 Token 数量 |
| -n | 16384 | 设置单次回答最多生成Token,与 -c 参数值一致 |
五、接入 DeepSeek Harness 和 Hermes Agent
1. 接入 DeepSeek Harness
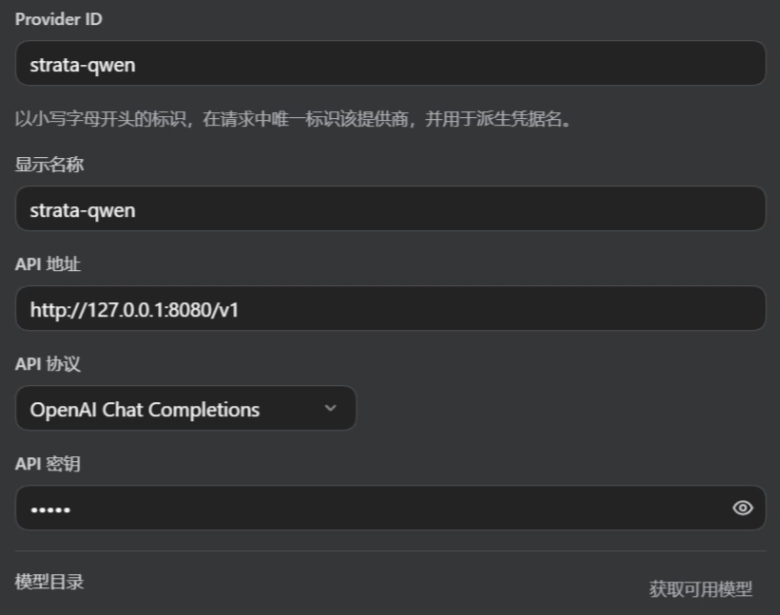
接入参数:
Provider ID: strata-qwen
显示名称: strata-qwen
API 地址:http://127.0.0.1:8085/v1
API 协议: OpenAI Chat Completions
API Key: 随便填一个
添加模型:点击"获取可用模型"
2. 接入 Hermes Agent
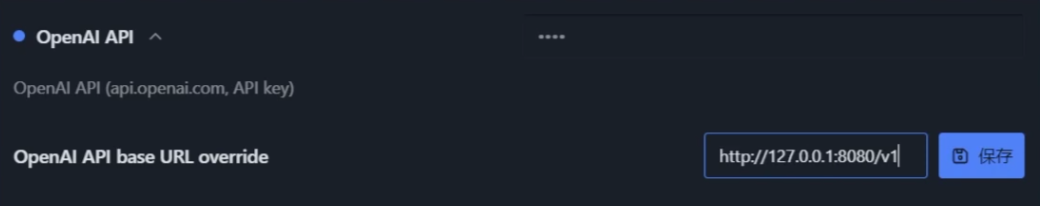
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:8085/v1