大家好,我是超哥。今天给大家分享 Qwen3.8-27B 无审查版多模态 AI 大模型的本地部署教程!这款模型主打开放式对话与强大的文本推理能力,支持最高 262K 超长上下文和 MTP 加速技术,同时还支持图片识别与理解。今天我们将使用 llama.cpp 在本地部署这个模型,并接入 Hermes Agent。下面我们开始教程!
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB DDR5(3600 MHz)
一、Qwen3.8 27B 大模型下载
夸克网盘模型下载地址:https://pan.quark.cn/s/64a07524a24e?pwd=AytQ
Hugging Face 模型下载地址:https://huggingface.co/JonathanColetti/Qwen3.8-27B-Uncensored-GGUF/tree/main
Qwen3.8 27B 模型版本选择推荐:
| 模型版本 | 文件大小 | 推荐显存 | 推荐说明 |
|---|---|---|---|
| IQ2_M | 10.6 GB | 8GB 起 | 适合显存有限的用户,部分模型层可交由系统内存运行 |
| IQ4_XS | 15.3 GB | 16GB 起 | 适合 16GB 显存用户优先尝试,兼顾模型体积与量化精度 |
| Q4_K_M | 16.8 GB | 16GB 起 | 常用的 4-bit 量化版本,兼顾输出效果与资源占用 |
| Q5_K_M | 19.5 GB | 20GB 起 | 量化精度较高,适合追求更好输出质量的用户 |
| Q6_K | 22.4 GB | 24GB 起 | 较高精度量化版本,适合内存资源充足的用户 |
| Q8_0 | 29 GB | 32GB 起 | 高精度量化版本,适合显存充足、注重输出质量的用户 |
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
夸克网盘下载地址:https://pan.quark.cn/s/cb446ec27f32?pwd=pRrC
Github 下载地址:https://github.com/ggml-org/llama.cpp/releases
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
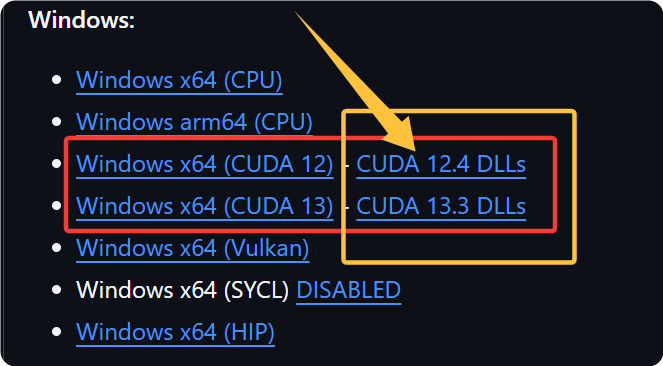
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、Qwen3.8 27B 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
@echo off
chcp 65001 >nul
title Qwen3.8-27B-Uncensored-GGUF - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       llama.cpp Local AI Server
echo ========================================
echo.
echo       Model: Qwen3.8-27B-Uncensored
echo.

llama-server.exe ^
  -m "models\模型名" ^
  --mmproj "models\mmproj-Qwen3.8-27B-Uncensored-F16.gguf" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 65536 ^
  --fit on ^
  -fa auto ^
  --jinja ^
  --parallel 1 ^
  --alias Qwen3.8-27B-Uncensored ^
  --temp 0.6 ^
  --top-p 0.95 ^
  --top-k 20 ^
  --repeat-penalty 1.05 ^
  --spec-type draft-mtp ^
  --spec-draft-n-max 4 ^
  -ngl 99 ^
  -n 8192

pause
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 模型名 | 指定主模型文件 |
| --mmproj | mmproj-Qwen3.8-27B-Uncensored-F16.gguf | 加载视觉投影文件,支持图片输入 |
| --host | 127.0.0.1 | 仅允许本机访问 |
| --port | 8085 | 设置服务端口 |
| -c | 65536 | 设置上下文长度为 64K Token |
| --fit | on | 自动调整参数以适配硬件资源 |
| -fa | auto | 自动设置 Flash Attention |
| --jinja | 开启 | 启用 Jinja 聊天模板 |
| --parallel | 1 | 设置单路并行处理 |
| --alias | Qwen3.8-27B-Uncensored | 设置模型显示名称 |
| --temp | 0.6 | 控制回答的随机性 |
| --top-p | 0.95 | 控制候选 Token 的累计概率 |
| --top-k | 20 | 限制候选 Token 数量 |
| --repeat-penalty | 1.05 | 轻微抑制重复内容 |
| --spec-type | draft-mtp | 启用 MTP 推测解码 |
| --spec-draft-n-max | 4 | 设置每轮最多预测 4 个 Token |
| -ngl | 99 | 尽可能将模型层加载到 GPU |
| -n | 8192 | 设置单次回答最多生成 8192 个 Token |
注意:如果使用不带mtp加速的模型文件,需要去掉下面2个参数
--spec-type draft-mtp ^
--spec-draft-n-max 4 ^
三、接入 Hermes Agent
Hermes Agent 下载地址:https://hermes-agent.nousresearch.com/
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:8085/v1