大家好,我是超哥。今天给大家分享 LFM2.5-24B-A2B 无审查版 AI 模型的本地部署教程。它拥有 24B 总参数、2B 激活参数,支持最高 131K 上下文,并且主打更开放的回答风格。今天我们将使用 llama.cpp 本地部署,并接入 Hermes Agent。下面开始今天的教程!
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB DDR5(3600 MHz)
一、LFM2.5-24B-A2B 大模型下载
Hugging Face模型下载地址:https://huggingface.co/AtomicChat/LFM2.5-24B-A2B-Uncensored-GGUF/tree/main
夸克网盘模型下载地址:https://pan.quark.cn/s/97c88aa26d0f?pwd=s2Xy
迅雷网盘模型下载地址:https://pan.xunlei.com/s/VP3upvEnos4CQq7kU5pBsRrlA1?pwd=g2mu
电脑配置模型选择推荐(建议最低 8GB 显存):
| 模型版本 | 文件大小 | 适用显存 | 推荐说明 |
|---|---|---|---|
| LFM2.5-24B-A2B-Uncensored-AD-IQ3_M | 12.1 GB | 8GB 及以上 | 3-bit 量化,适合低显存电脑 |
| LFM2.5-24B-A2B-Uncensored-AD-IQ4_XS | 14.5 GB | 8GB 及以上 | 4-bit 超小量化,兼顾体积与效果 |
| LFM2.5-24B-A2B-Uncensored-AD-Q4_K_M | 15.4 GB | 8GB 及以上 | 4-bit 均衡版,综合推荐 |
| LFM2.5-24B-A2B-Uncensored-AD-Q5_K_M | 17.3 GB | 8GB 及以上 | 5-bit 量化,兼顾质量与资源占用 |
| LFM2.5-24B-A2B-Uncensored-AD-Q6_K | 20.9 GB | 12GB 及以上 | 6-bit 高质量版本 |
| LFM2.5-24B-A2B-Uncensored-AD-Q8_0 | 25.7 GB | 16GB 及以上 | 8-bit 高精度版本,你的 16GB 显卡已实测可运行 |
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
Github项目下载地址:https://github.com/ggml-org/llama.cpp/releases
夸克网盘项目下载地址:https://pan.quark.cn/s/8dcef244efec?pwd=TM92
迅雷网盘项目下载地址:https://pan.xunlei.com/s/VP3uf7aY_uP6z1c9NXp-wkA3A1?pwd=4gkr
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
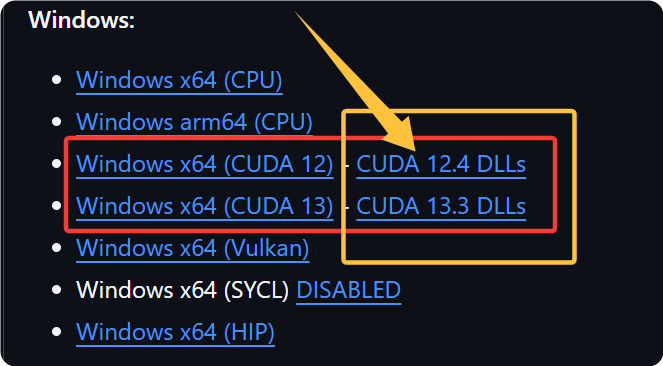
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、LFM2.5-24B-A2B 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
@echo off
title LFM2.5-24B-A2B-Uncensored - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       llama.cpp Local AI Server
echo ========================================
echo.
echo       Model: LFM2.5-24B-A2B-Uncensored
echo.

llama-server.exe ^
  -m "models\模型名" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 65536 ^
  --fit on ^
  -fa auto ^
  --jinja ^
  --reasoning off ^
  --parallel 1 ^
  --alias LFM2.5-24B-A2B-Uncensored ^
  --temp 0.1 ^
  --top-k 50 ^
  --repeat-penalty 1.05 ^
  -n 65536

pause
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 模型名 | 指定量化主模型 |
| --host | 127.0.0.1 | 仅允许本机访问服务 |
| --port | 8085 | 设置 llama.cpp 服务端口,可通过浏览器访问本地 Web 界面 |
| -c | 65536 | 设置上下文长度为 64K Token,模型最高支持 128K 上下文,可根据硬件情况调整 |
| --fit | on | 自动调整模型加载参数,尽可能适配可用显存和内存 |
| -fa | auto | 自动选择是否使用 Flash Attention |
| --jinja | 开启 | 启用 Jinja 聊天模板处理 |
| --reasoning | off | 关闭推理输出模式,具体效果取决于 llama.cpp 版本及模型模板 |
| --parallel | 1 | 设置并行处理槽位为 1 |
| --alias | LFM2.5-24B-A2B-Uncensored | 设置 API 中显示的模型名称 |
| --temp | 0.1 | 控制生成内容的随机性,数值越低通常越稳定 |
| --top-k | 50 | 每一步采样时,将候选 Token 限制在概率较高的 50 个以内 |
| --repeat-penalty | 1.05 | 适度惩罚重复内容,降低重复生成的概率 |
| -n | 65536 | 单次生成最多允许输出 65536 Token,实际输出长度还受上下文空间和请求参数限制 |
三、接入 Hermes Agent
Hermes Agent 下载地址:https://hermes-agent.nousresearch.com/
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:8085/v1