大家好,我是超哥。今天给大家分享 Arete-27B 多模态 AI 大模型的本地部署教程!这款模型基于阿里巴巴的 Qwen3.8-27B,拥有约 270 亿参数,由 Nous Research 重新训练,重点强化了西方价值观取向。它支持图片识别,最大支持 256K 上下文。今天我们将使用 llama.cpp 在本地部署,下面我们开始教程。
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB DDR5(3600 MHz)
一、大模型下载
Hugging Face 主模型下载地址:https://huggingface.co/bartowski/NousResearch_Arete-27B-GGUF/tree/main
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
Github 下载地址:https://github.com/ggml-org/llama.cpp/releases
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
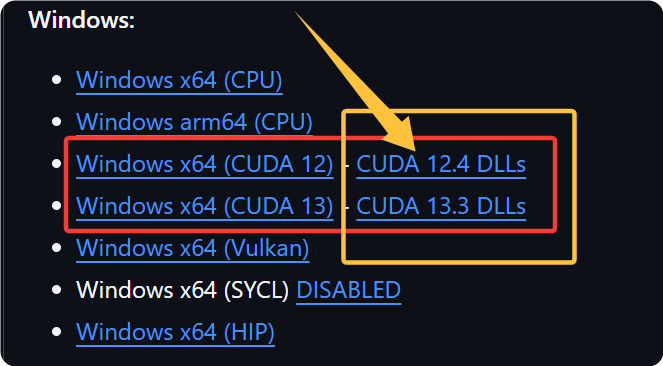
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、AI 模型 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
@echo off
chcp 65001 >nul
title Arete-27B Multimodal - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       Arete-27B
echo       Multimodal llama.cpp Server
echo ========================================
echo.

echo Model: Q4_0
 echo Context: 8192
 echo GPU offload: auto fit
 echo.

llama-server.exe ^
  -m "models\模型名" ^
  --mmproj "models\多模态名" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 8192 ^
  -np 1 ^
  --fit on ^
  -fa on ^
  --jinja ^
  -ngl 99 ^
  --alias Arete-27B ^
  --temp 1.0 ^
  --top-p 0.95 ^
  --top-k 20 ^
  -n 16384

pause
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 模型名 | 指定 Arete-27B 主模型文件(Q4_0) |
| --mmproj | 多模态名 | 指定 BF16 多模态投影文件,用于图像输入处理 |
| --host | 127.0.0.1 | 仅允许本机访问模型服务 |
| --port | 8085 | 设置服务监听端口 |
| -c | 8192 | 上下文长度,当前设置为8192,模型架构最大支持256000 |
| -np | 1 | 设置单路并行处理 |
| --fit | on | 自动调整模型配置,以适配可用硬件资源 |
| -fa | on | 开启 Flash Attention,优化注意力计算性能 |
| --jinja | 开启 | 启用 Jinja 聊天模板处理,适配模型原生对话格式 |
| -ngl | 99 | 尽可能将模型层加载到 GPU,实际加载数量受显存限制 |
| --alias | Arete-27B | 设置 API 中使用的模型名称 |
| --temp | 1.0 | 控制生成随机性,数值越高,输出通常越有创造性 |
| --top-p | 0.95 | 设置核采样阈值,控制候选 Token 的选择范围 |
| --top-k | 20 | 限制每次采样时参与选择的候选 Token 数量 |
| -n | 16384 | 设置单次回答最多生成的 Token 数量,实际生成长度还受上下文窗口限制 |
五、接入 Hermes Agent
注意:接入前模型上下文长度记得设置成大于65000
OpenAI api 参数:
API 秘钥: 随便填一个
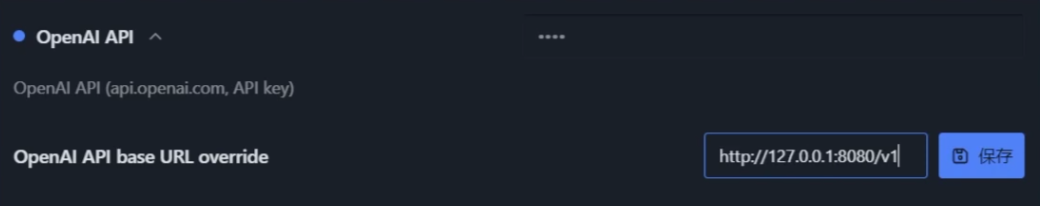
Base URL:http://127.0.0.1:8085/v1