大家好,我是超哥。今天给大家分享 Qwen3.8-35B-A3B 多模态 AI模型本地部署教程。它具备 262K上下文,同时支持多模态图像理解,模型能力强、运行门槛低,即使是3060显卡也能够成功运行。我还会带大家接入 Hermes Agent,实现工具调用、网页操作等 Agent功能。下面我们开始教程。
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB(3600 MHz)
一、Qwen3.8-35B-A3B 大模型下载
Hugging Face下载地址:https://huggingface.co/empero-ai/Qwen3.8-35B-A3B-Distill-GGUF/tree/main
夸克网盘下载地址:https://pan.quark.cn/s/e33c9e5cc999?pwd=bMYH
注意:网盘下载地址里的内容一定要保存到你自己的网盘,我后面会删掉。
电脑配置模型选择推荐(内存大的可以往下再提一格):
| 模型版本 | 文件大小 | 适用显存 | 推荐说明 |
|---|---|---|---|
| Qwen3.8-35B-A3B-IQ2_M | 约 12.6 GB | 12GB 显存及以上 | 最低体积,适合低显存设备 |
| Qwen3.8-35B-A3B-Q2_K | 约 13.8 GB | 12GB 显存及以上 | 2-bit 量化,低显存友好 |
| Qwen3.8-35B-A3B-IQ3_M | 约 16.3 GB | 16GB 显存及以上 | 3-bit 量化,精度进一步提升 |
| Qwen3.8-35B-A3B-Q3_K_M | 约 17.7 GB | 16GB 显存及以上 | 传统 3-bit K 量化 |
| Qwen3.8-35B-A3B-IQ4_XS | 约 19.6 GB | 16GB 显存及以上 | 体积较小,接近 Q4_K_M 效果 |
| Qwen3.8-35B-A3B-Q4_K_M | 约 21.7 GB | 24GB 显存及以上 | 官方推荐,效果与体积均衡 |
| Qwen3.8-35B-A3B-Q5_K_M | 约 25.3 GB | 32GB 显存及以上 | 更高精度,适合高显存设备 |
| Qwen3.8-35B-A3B-Q6_K | 约 29.2 GB | 32GB 显存及以上 | 接近无损,追求更高质量 |
| Qwen3.8-35B-A3B-Q8_0 | 约 37.8 GB | 48GB 显存及以上 | 最高质量量化版本 |
| Qwen3.8-35B-A3B-BF16 | 约 71.1 GB | 80GB 显存及以上 | 完整精度版本,仅供参考 |
| mmproj-Qwen3.8-35B-A3B-F16 | 约 899 MB | -- | 视觉投影文件,搭配模型实现图片输入 |
X超哥推特(X):https://x.com/xchaoge
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
Github 下载地址:https://github.com/ggml-org/llama.cpp/releases
夸克网盘下载地址:https://pan.quark.cn/s/f069fa0a162d?pwd=R2vL
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
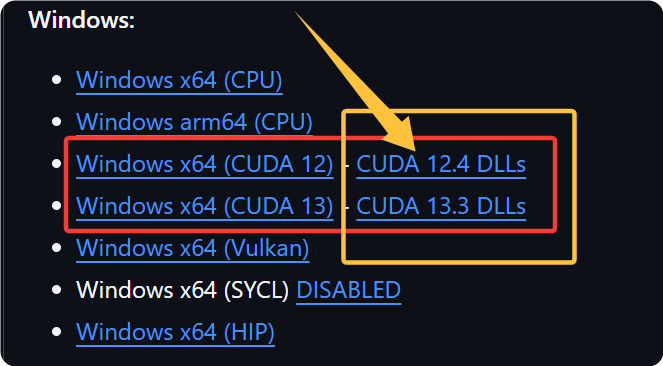
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、Qwen3.8-35B-A3B 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
llama-server.exe ^
  -m "models\模型名" ^
  --mmproj "models\mmproj-Qwen3.8-35B-A3B-F16.gguf" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 65536 ^
  -ngl 99 ^
  -fa auto ^
  --jinja ^
  --parallel 1 ^
  --alias Qwen3.8-35B-A3B-Distill ^
  --temp 0.6 ^
  --top-p 0.95 ^
  --top-k 20 ^
  --repeat-penalty 1.05 ^
  --cache-type-k q8_0 ^
  --cache-type-v q8_0 ^
  --reasoning on ^
  -n 32768
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 模型文件 | 指定主模型 |
| --mmproj | F16 | 启用图片输入 |
| --host | 127.0.0.1 | 仅本机访问 |
| --port | 8085 | 设置服务端口 |
| -c | 65536 | 64K 上下文 |
| -ngl | 99 | 尽可能使用 GPU |
| -fa | auto | 自动使用 Flash Attention |
| --jinja | 开启 | 启用模型模板 |
| --parallel | 1 | 同时处理 1 个请求 |
| --alias | Qwen3.8-35B-A3B-Distill | 设置模型名称 |
| --temp | 0.6 | 控制生成随机性 |
| --top-p | 0.95 | 控制采样范围 |
| --top-k | 20 | 限制候选 Token |
| --repeat-penalty | 1.05 | 降低内容重复 |
| --cache-type-k | q8_0 | K Cache 使用 Q8_0 |
| --cache-type-v | q8_0 | V Cache 使用 Q8_0 |
| --reasoning | on | 开启推理模式 |
| -n | 32768 | 最多生成 16384 Token |
三、接入 Hermes Agent
Hermes Agent 下载地址:https://hermes-agent.nousresearch.com/
夸克网盘下载地址:https://pan.quark.cn/s/fd2e158b2d8b?pwd=RtRG
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:8085/v1