大家好,我是超哥。今天给大家分享 英伟达 Nemotron 3.5 Bolt 74B-A9B 24GB 多模态 AI 大模型的本地部署教程!它最大的亮点就是 74B 总参数、仅 9B 激活参数,让大模型也有机会在普通电脑上运行。同时它支持图片识别、视频识别以及最高 262K 上下文。今天我们将使用模型官方推荐的 llama.cpp 在本地部署这个模型,并接入 Hermes Agent。下面我们开始教程!
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB DDR5(3600 MHz)
一、Nemotron 3.5 Bolt 74B-A9B 大模型下载
Hugging Face模型下载地址:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF/tree/main
夸克网盘模型下载地址:https://pan.quark.cn/s/3a6e783cac39?pwd=Uvkk
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
Github项目下载地址:https://github.com/ggml-org/llama.cpp/releases
夸克网盘项目下载地址:https://pan.quark.cn/s/f97cabd6dc47?pwd=ZNCT
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
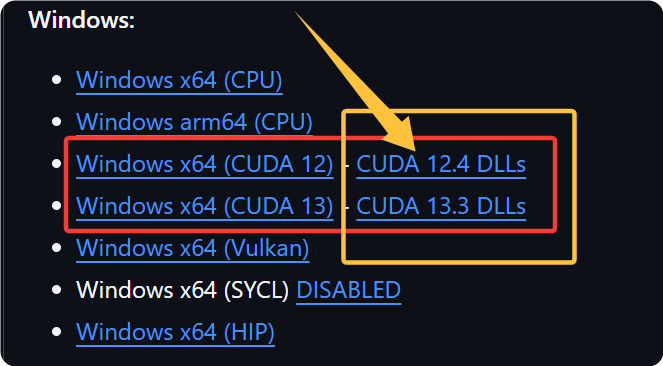
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、Nemotron 3.5 Bolt 74B-A9B 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
@echo off
chcp 65001 >nul
title Nemotron-3.5-Bolt-74B-A9B - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       llama.cpp Local AI Server
echo ========================================
echo.
echo       Model: Nemotron-3.5-Bolt-74B-A9B
echo.

llama-server.exe ^
  -m "models\NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf" ^
  --mmproj "models\mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 65536 ^
  -ngl 99 ^
  -fa on ^
  --jinja ^
  --parallel 1 ^
  --alias Nemotron-3.5-Bolt-74B-A9B ^
  --temp 0.7 ^
  --top-k 20 ^
  --top-p 0.8 ^
  --min-p 0 ^
  --repeat-penalty 1.0 ^
  --presence-penalty 1.5 ^
  --repeat-last-n 64

pause
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 主模型名 | 指定主模型文件 |
| --mmproj | 多模态名 | 加载视觉投影文件,支持图片输入 |
| --host | 127.0.0.1 | 仅允许本机访问 |
| --port | 8086 | 设置服务端口 |
| -c | 65536 | 设置上下文长度为 64K Token,最大262144上下文 |
| -ngl | 99 | 尽可能将模型层加载到 GPU |
| -fa | on | 启用 Flash Attention 加速 |
| --jinja | 开启 | 启用 Jinja 聊天模板 |
| --parallel | 1 | 设置单路并行处理 |
| --alias | Nemotron-3.5-Bolt-74B-A9B | 设置模型显示名称 |
| --temp | 0.7 | 控制回答的随机性 |
| --top-k | 20 | 限制候选 Token 数量 |
| --top-p | 0.8 | 控制候选 Token 的累计概率 |
| --min-p | 0 | 不启用最小概率过滤 |
| --repeat-penalty | 1.0 | 不额外惩罚重复内容 |
| --presence-penalty | 1.5 | 提高重复内容的出现惩罚 |
| --repeat-last-n | 64 | 检查最近 64 个 Token 的重复情况 |
三、接入 Hermes Agent
Hermes Agent 下载地址:https://hermes-agent.nousresearch.com/
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:8085/v1