大家好,我是超哥。今天给大家分享 Tiel-Coder-35B-A3B 多模态 AI 编程模型的本地部署教程。这个模型最大的特点就是低显存也能运行,6GB 显卡同样可以部署,同时拥有 262K 超长上下文,并支持 MTP 加速,可以进一步提升推理速度。模型部署到自己的电脑上之后,不需要 API Token,也不需要联网,就可以直接本地运行。我还会带大家将它接入 Hermes Agent,实现工具调用、网页操作等 Agent功能。我们直接开始教程。
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB(3600 MHz)
一、Tiel-Coder-35B-A3B 大模型下载
Hugging Face下载地址:https://huggingface.co/peculiar-ragdoll/Tiel-Coder-35B-A3B-GGUF-MTP
夸克网盘下载地址:https://pan.quark.cn/s/3c5038896f9e?pwd=1tA7
迅雷网盘下载地址:https://pan.xunlei.com/s/VP2ww64XPkDYXwGdEVMfJv9jA1?pwd=9mb6
电脑配置模型选择推荐(内存大的可以往下再提一格):
| 模型版本 | 文件大小 | 适用显存 | 推荐说明 |
|---|---|---|---|
| Tiel-Coder-35B-A3B-MTP-UD-Q2_K_XL | 约 12.7 GB | 6GB 显存及以上 | 最低量化 |
| Tiel-Coder-35B-A3B-MTP-UD-IQ3_XXS | 约 13.6 GB | 8GB 显存及以上 | 低显存推荐 |
| Tiel-Coder-35B-A3B-MTP-UD-Q3_K_XL | 约 17.2 GB | 8GB 显存及以上 | 3-bit 量化 |
| Tiel-Coder-35B-A3B-MTP-UD-IQ4_XS | 约 18.1 GB | 12GB 显存及以上 | 4-bit 推荐 |
| Tiel-Coder-35B-A3B-MTP-UD-Q4_K_S | 约 21.3 GB | 12GB 显存及以上 | 4-bit 高质量 |
| Tiel-Coder-35B-A3B-MTP-UD-Q4_K_XL | 约 22.7 GB | 16GB 显存及以上 | 均衡推荐 |
| Tiel-Coder-35B-A3B-MTP-UD-Q5_K_XL | 约 27 GB | 16GB 显存及以上 | 高质量 |
| Tiel-Coder-35B-A3B-MTP-UD-Q6_K_XL | 约 32.2 GB | 24GB 显存及以上 | 高精度 |
| Tiel-Coder-35B-A3B-MTP-UD-Q8_K_XL | 约 38.8 GB | 32GB 显存及以上 | 最高精度 |
| mmproj-BF16 | 约 903 MB | -- | 多模态视觉 |
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
Github 下载地址:https://github.com/ggml-org/llama.cpp/releases
夸克网盘下载地址:https://pan.quark.cn/s/5b91f8d47cac?pwd=SZP6
迅雷网盘下载地址:https://pan.xunlei.com/s/VP2wioNgUT8yOkE4wLQxqKJCA1?pwd=r2ig
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
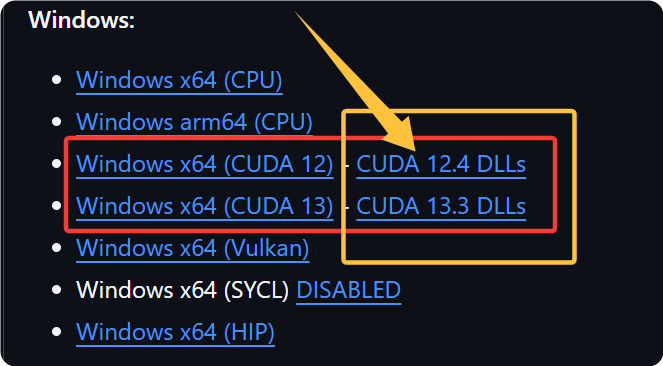
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、Tiel-Coder-35B-A3B 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
@echo off
title Tiel-Coder-35B-A3B-MTP - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       llama.cpp Local AI Server
echo ========================================
echo.
echo       Tiel-Coder-35B-A3B-MTP
echo       Q4_K_XL + Vision + MTP
echo.

llama-server.exe ^
  -m "models\模型名" ^
  --mmproj "models\mmproj-BF16.gguf" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 65536 ^
  --fit on ^
  -fa auto ^
  --jinja ^
  --parallel 1 ^
  --alias Tiel-Coder-35B-A3B-MTP ^
  --temp 0.6 ^
  --top-p 0.95 ^
  --top-k 20 ^
  --repeat-penalty 1.05 ^
  --cache-type-k q8_0 ^
  --cache-type-v q8_0 ^
  --spec-type draft-mtp ^
  --spec-draft-n-max 2 ^
  --spec-draft-p-min 0.0 ^
  -n 32768

pause
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 模型文件 | 指定 Tiel-Coder 主模型 |
| --mmproj | mmproj-BF16.gguf | 启用图片输入和视觉能力 |
| --host | 127.0.0.1 | 仅允许本机访问 |
| --port | 8085 | 设置 API 服务端口 |
| -c | 65536 | 设置 64K 上下文长度 |
| --fit | on | 根据设备显存自动调整模型加载参数 |
| -fa | auto | 自动使用 Flash Attention |
| --jinja | 开启 | 启用模型聊天模板 |
| --parallel | 1 | 同时处理 1 个请求 |
| --alias | Tiel-Coder-35B-A3B-MTP | 设置 API 中显示的模型名称 |
| --temp | 0.6 | 控制生成内容的随机性 |
| --top-p | 0.95 | 控制候选 Token 的采样范围 |
| --top-k | 20 | 限制候选 Token 数量 |
| --repeat-penalty | 1.05 | 降低生成内容重复 |
| --cache-type-k | q8_0 | K Cache 使用 Q8_0 量化 |
| --cache-type-v | q8_0 | V Cache 使用 Q8_0 量化 |
| --spec-type | draft-mtp | 启用模型内置 MTP 加速 |
| --spec-draft-n-max | 2 | 设置 MTP 每轮最多预测的 Token 数 |
| --spec-draft-p-min | 0.0 | 设置 MTP 接受 Token 的最低概率阈值 |
| -n | 32768 | 最多生成 32768 Token |
三、接入 Hermes Agent
Hermes Agent 下载地址:https://hermes-agent.nousresearch.com/
夸克网盘下载地址:https://pan.quark.cn/s/fd2e158b2d8b?pwd=RtRG
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:8085/v1