大家好,我是超哥。今天给大家分享 微软 FrogNano 4B 多模态 AI 模型的本地部署教程。这个模型最大的特点就是体积非常小,最小量化版本只有 1.65GB,4GB 显卡就可以运行,同时支持图片识别和 131K 上下文长度。模型部署到自己的电脑上之后,不需要 API Token,也不需要联网,就可以直接本地运行。我还会带大家将它接入 Hermes Agent,实现工具调用等 Agent 功能。我们直接开始教程。
博主电脑环境
显卡:NVIDIA RTX 4080 SUPER(16GB)
CPU:AMD R9 7900X 12-Core Processor(12核)
内存:64GB DDR5(3600 MHz)
一、FrogNano 4B 大模型下载
Hugging Face模型下载地址:https://huggingface.co/bartowski/FrogNano-4B-2609-GGUF
夸克网盘模型下载地址:https://pan.quark.cn/s/81c483c396c5?pwd=62ax
迅雷网盘模型下载地址:https://pan.xunlei.com/s/VP3AfyEJuQjNbyD58A0eEcheA1?pwd=4gvi
电脑配置模型选择推荐(内存大的可以往下再提一格):
| 模型版本 | 文件大小 | 适用显存 | 推荐说明 |
|---|---|---|---|
| FrogNano-4B-2609-IQ2_M | 约 1.65 GB | 4GB 显存及以上 | 极限低显存 |
| FrogNano-4B-2609-Q2_K | 约 1.80 GB | 4GB 显存及以上 | 最低量化 |
| FrogNano-4B-2609-IQ3_XXS | 约 1.98 GB | 4GB 显存及以上 | 低显存推荐 |
| FrogNano-4B-2609-IQ3_XS | 约 2.05 GB | 4GB 显存及以上 | 低显存推荐 |
| FrogNano-4B-2609-Q3_K_S | 约 2.04 GB | 4GB 显存及以上 | 3-bit 低显存 |
| FrogNano-4B-2609-Q3_K_M | 约 2.14 GB | 4GB 显存及以上 | 3-bit 均衡 |
| FrogNano-4B-2609-Q3_K_L | 约 2.24 GB | 4GB 显存及以上 | 3-bit 高质量 |
| FrogNano-4B-2609-IQ3_M | 约 2.35 GB | 4GB 显存及以上 | 3-bit 高质量 |
| FrogNano-4B-2609-Q4_K_S | 约 2.62 GB | 6GB 显存及以上 | 4-bit 低显存 |
| FrogNano-4B-2609-Q4_0 | 约 2.72 GB | 6GB 显存及以上 | 4-bit 基础 |
| FrogNano-4B-2609-IQ4_NL | 约 2.79 GB | 6GB 显存及以上 | 4-bit 高质量 |
| FrogNano-4B-2609-Q4_K_M | 约 2.80 GB | 6GB 显存及以上 | 4-bit 推荐 |
| FrogNano-4B-2609-Q4_1 | 约 2.92 GB | 6GB 显存及以上 | 4-bit 高质量 |
| FrogNano-4B-2609-Q4_K_L | 约 2.97 GB | 6GB 显存及以上 | 4-bit 高质量 |
| FrogNano-4B-2609-Q5_K_S | 约 3.15 GB | 6GB 显存及以上 | 5-bit 高质量 |
| FrogNano-4B-2609-Q5_K_M | 约 3.36 GB | 8GB 显存及以上 | 5-bit 推荐 |
| FrogNano-4B-2609-Q6_K_S | 约 3.61 GB | 8GB 显存及以上 | 6-bit 高质量 |
| FrogNano-4B-2609-Q6_K | 约 3.76 GB | 8GB 显存及以上 | 6-bit 高精度 |
| FrogNano-4B-2609-Q6_K_L | 约 3.92 GB | 8GB 显存及以上 | 6-bit 高精度 |
| FrogNano-4B-2609-Q8_0 | 约 4.62 GB | 10GB 显存及以上 | 高精度量化 |
| FrogNano-4B-2609-bf16 | 约 8.67 GB | 12GB 显存及以上 | 原始精度 |
| mmproj-FrogNano-4B-2609-f16 | 约 672 MB | -- | 多模态视觉模块 |
| mmproj-FrogNano-4B-2609-bf16 | 约 676 MB | -- | 多模态视觉模块 |
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
Github项目下载地址:https://github.com/ggml-org/llama.cpp/releases
夸克网盘项目下载地址:https://pan.quark.cn/s/783acfb7a4c0?pwd=Uywu
迅雷网盘项目下载地址:https://pan.xunlei.com/s/VP3AQD5UlRKP3JmuClmz_7HiA1?pwd=yufk
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
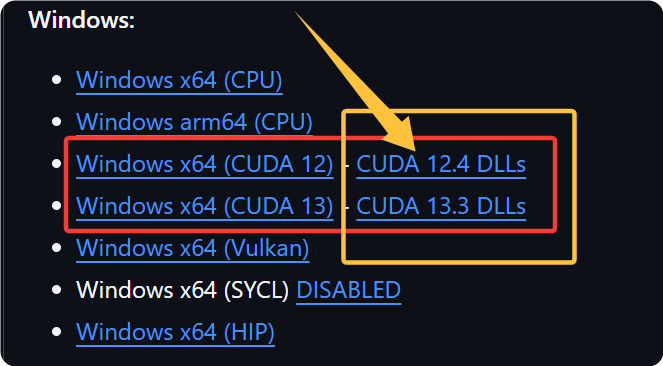
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、FrogNano 4B 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
llama.ccp 程序的根目录创建启动脚本,命名成:启动.bat
@echo off
title FrogNano-4B-2609-BF16 - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       llama.cpp Local AI Server
echo ========================================
echo.
echo       FrogNano-4B-2609
echo.

llama-server.exe ^
  -m "models\模型名" ^
  --mmproj "models\多模态名" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 65536 ^
  --fit on ^
  -fa auto ^
  --jinja ^
  --parallel 1 ^
  --alias FrogNano-4B-2609^
  --temp 0.6 ^
  --top-p 0.95 ^
  --top-k 20 ^
  --repeat-penalty 1.05 ^
  --cache-type-k q8_0 ^
  --cache-type-v q8_0 ^
  -n 32768

pause
访问控制面板 URL:
参数说明:
| 参数 | 设置 | 说明 |
|---|---|---|
| -m | 量化模型名称 | 指定 FrogNano 4B BF16 主模型 |
| --mmproj | 多模态模型名称 | 加载视觉投影模块,启用图片输入能力 |
| --host | 127.0.0.1 | 仅允许本机访问 |
| --port | 8085 | 设置 llama.cpp API 服务端口 |
| -c | 65536 | 设置 64K 上下文长度 |
| --fit | on | 根据设备显存情况自动调整模型加载参数 |
| -fa | auto | 自动使用 Flash Attention |
| --jinja | 开启 | 启用模型聊天模板 |
| --parallel | 1 | 同时处理 1 个请求 |
| --alias | FrogNano-4B-2609-BF16 | 设置 API 中显示的模型名称 |
| --temp | 0.6 | 控制生成内容的随机性 |
| --top-p | 0.95 | 控制候选 Token 的采样范围 |
| --top-k | 20 | 限制候选 Token 数量 |
| --repeat-penalty | 1.05 | 降低生成内容重复 |
| --cache-type-k | q8_0 | K Cache 使用 Q8_0 量化,降低 KV Cache 显存占用 |
| --cache-type-v | q8_0 | V Cache 使用 Q8_0 量化,降低 KV Cache 显存占用 |
| -n | 32768 | 最多生成 32768 Token |
三、接入 Hermes Agent
Hermes Agent 下载地址:https://hermes-agent.nousresearch.com/
夸克网盘下载地址:https://pan.quark.cn/s/fd2e158b2d8b?pwd=RtRG
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:8085/v1