大家好,我是超哥。今天给大家分享 MiniCPM5 2B AI 模型本地部署教程,它具备超长 131K 上下文,模型体积小、运行门槛低,即使是普通电脑也能轻松部署,还可以接入 Hermes Agent,实现工具调用、网页操作等 Agent 功能。在实际测试中,它的整体表现也相当出色,运行速度优于 Qwen3.5-4B 和 Gemma 4 E2B。下面我们开始教程。
一、MiniCPM5-2B 大模型下载
Hugging Face下载地址:https://huggingface.co/openbmb/MiniCPM5-2B-GGUF
夸克网盘下载地址:https://pan.quark.cn/s/c00294675cb9?pwd=6DbT
迅雷下载地址:https://pan.xunlei.com/s/VP1K2bt0EkOWFZIu4vTCSSL3A1?pwd=tp5b
百度网盘下载地址:https://pan.baidu.com/s/169L7DT6P4Mrp3xLoFBIXFQ?pwd=iwhy
电脑配置选择推荐:
| 模型版本 | 文件大小 | 适用电脑 | 推荐说明 |
|---|---|---|---|
| MiniCPM5-2B-F16 | 约 5.04 GB | 高内存、显存充足 | 追求最高精度 |
| MiniCPM5-2B-Q8_0 | 约 2.68 GB | 中高端电脑、8GB 显存 | 效果与速度均衡 |
| MiniCPM5-2B-Q4_K_M | 约 1.56 GB | 普通电脑、低显存、CPU | 占用最低,优先推荐 |
X超哥推特:https://x.com/xchaoge
二、下载并配置 llama.cpp
1、下载并安装 llama.cpp
下载地址:https://github.com/ggml-org/llama.cpp/releases
| 版本 | 适用硬件 | 说明 |
|---|---|---|
| Windows x64 (CPU) | Intel / AMD CPU | 仅使用处理器运行 |
| Windows arm64 (CPU) | ARM 架构 Windows 设备 | 适用于骁龙 X Elite 等 ARM 平台 |
| Windows x64 (CUDA 12) | NVIDIA 显卡 | 推荐大多数 RTX/GTX 用户使用 |
| Windows x64 (CUDA 13) | NVIDIA 显卡 | 适用于较新的 NVIDIA 驱动 |
| Windows x64 (Vulkan) | AMD / Intel / NVIDIA 显卡 | 通用显卡加速版本 |
| Windows x64 (SYCL) | Intel Arc 显卡 | Intel Arc 用户专用版本 |
| Windows x64 (HIP) | AMD Radeon 显卡 | AMD 用户首选版本 |
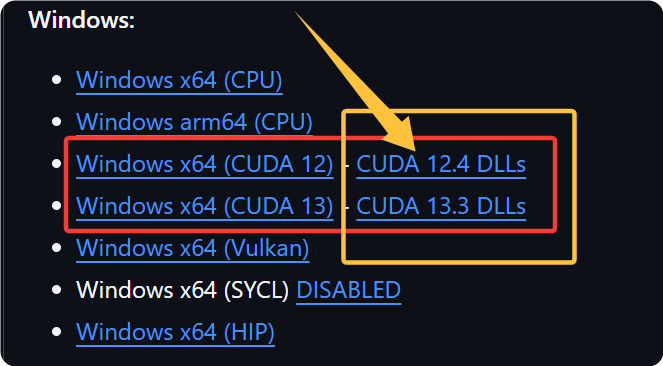
注意:显卡用户别忘了下载下图主程序后面的DLLs文件,下载后把里面的内容解压到llama.ccp主程序的根目录里,不然无法使用显卡运行模型。
2、MiniCPM5-2B 接入 llama.cpp
把下载到的大模型放到 llama.ccp 程序的根目录下的 models 目录里(需自行创建目录)
3、配置启动脚本
创建启动脚本,命名成:启动.bat
@echo off
title MiniCPM5-2B F16 - llama.cpp

cd /d "%~dp0"

echo.
echo ========================================
echo       XChaoGe.Com
echo       llama.cpp Local AI Server
echo ========================================
echo.

llama-server.exe ^
  -m "models\MiniCPM5-2B-F16.gguf" ^
  --host 127.0.0.1 ^
  --port 8085 ^
  -c 65536 ^
  -ngl 99 ^
  -fa auto ^
  --jinja ^
  --parallel 1 ^
  --alias MiniCPM5-2B ^
  --temp 1.0 ^
  --top-p 0.95

pause
访问控制面板 URL:
代码说明:
-m "models\模型名" ^
--port 端口号 ^
-c 上下文长度 ^
三、接入 Hermes Agent
Hermes Agent 下载地址:https://hermes-agent.nousresearch.com/
OpenAI api 参数:
API 秘钥: 随便填一个
Base URL:http://127.0.0.1:端口号/v1